基础功能
Elasticsearch 是一个分布式、RESTful 风格的搜索和数据分析引擎。
可以直接用http请求去操作数据。例如:
http://localhost:9200/索引名称 # 创建索引请求方式 PUT
如下图:es_db为索引名称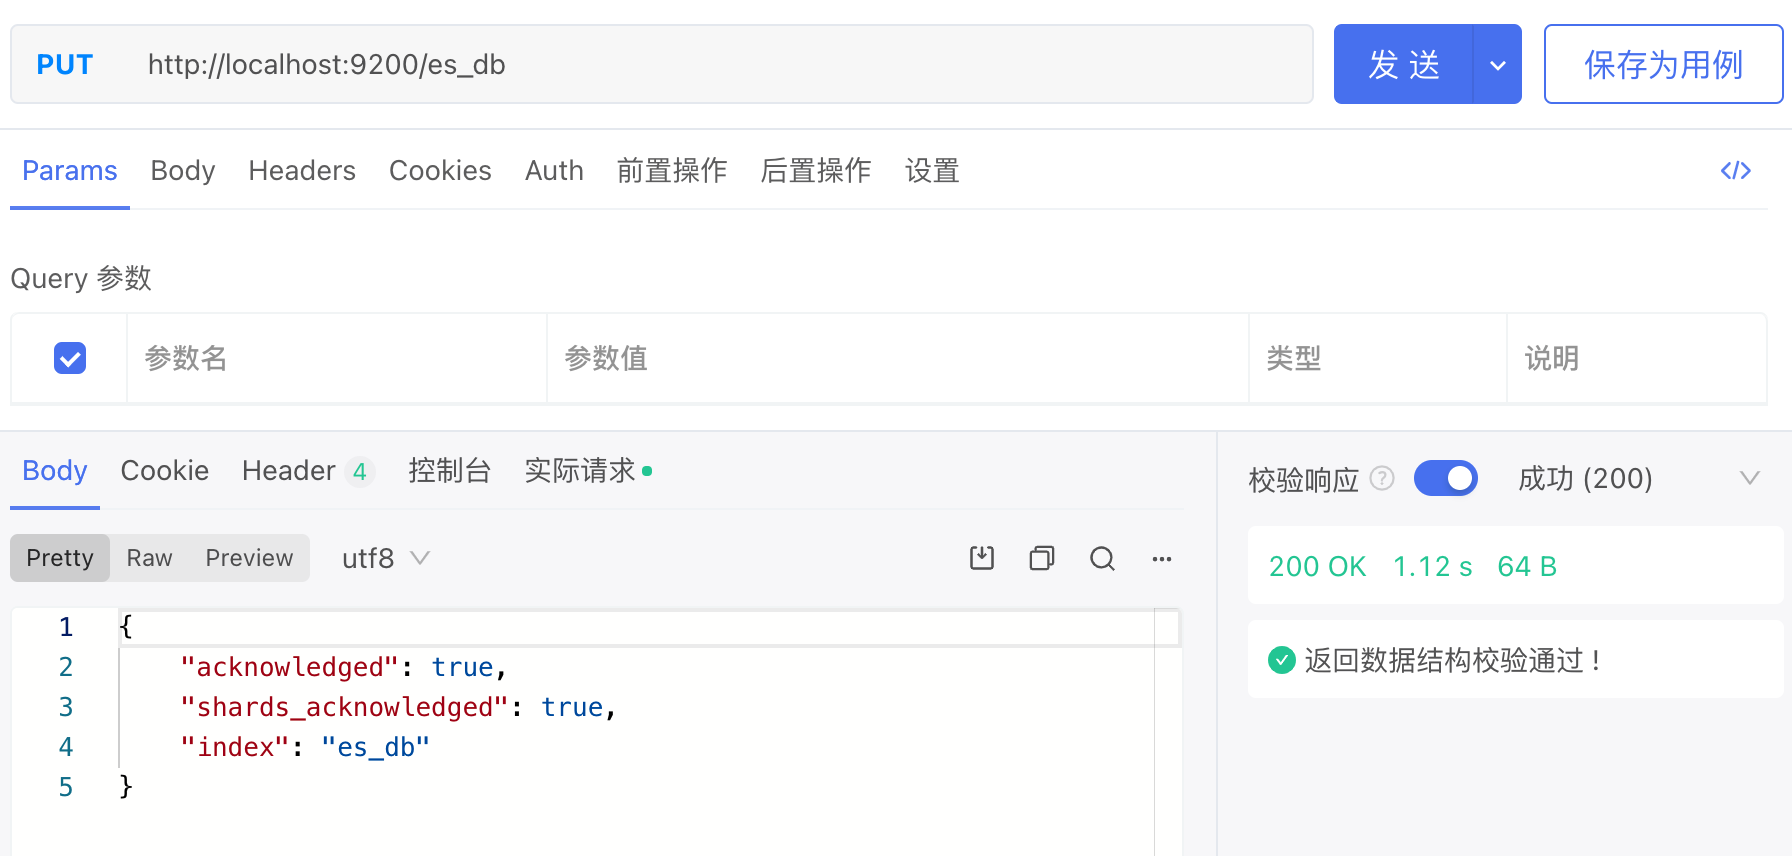
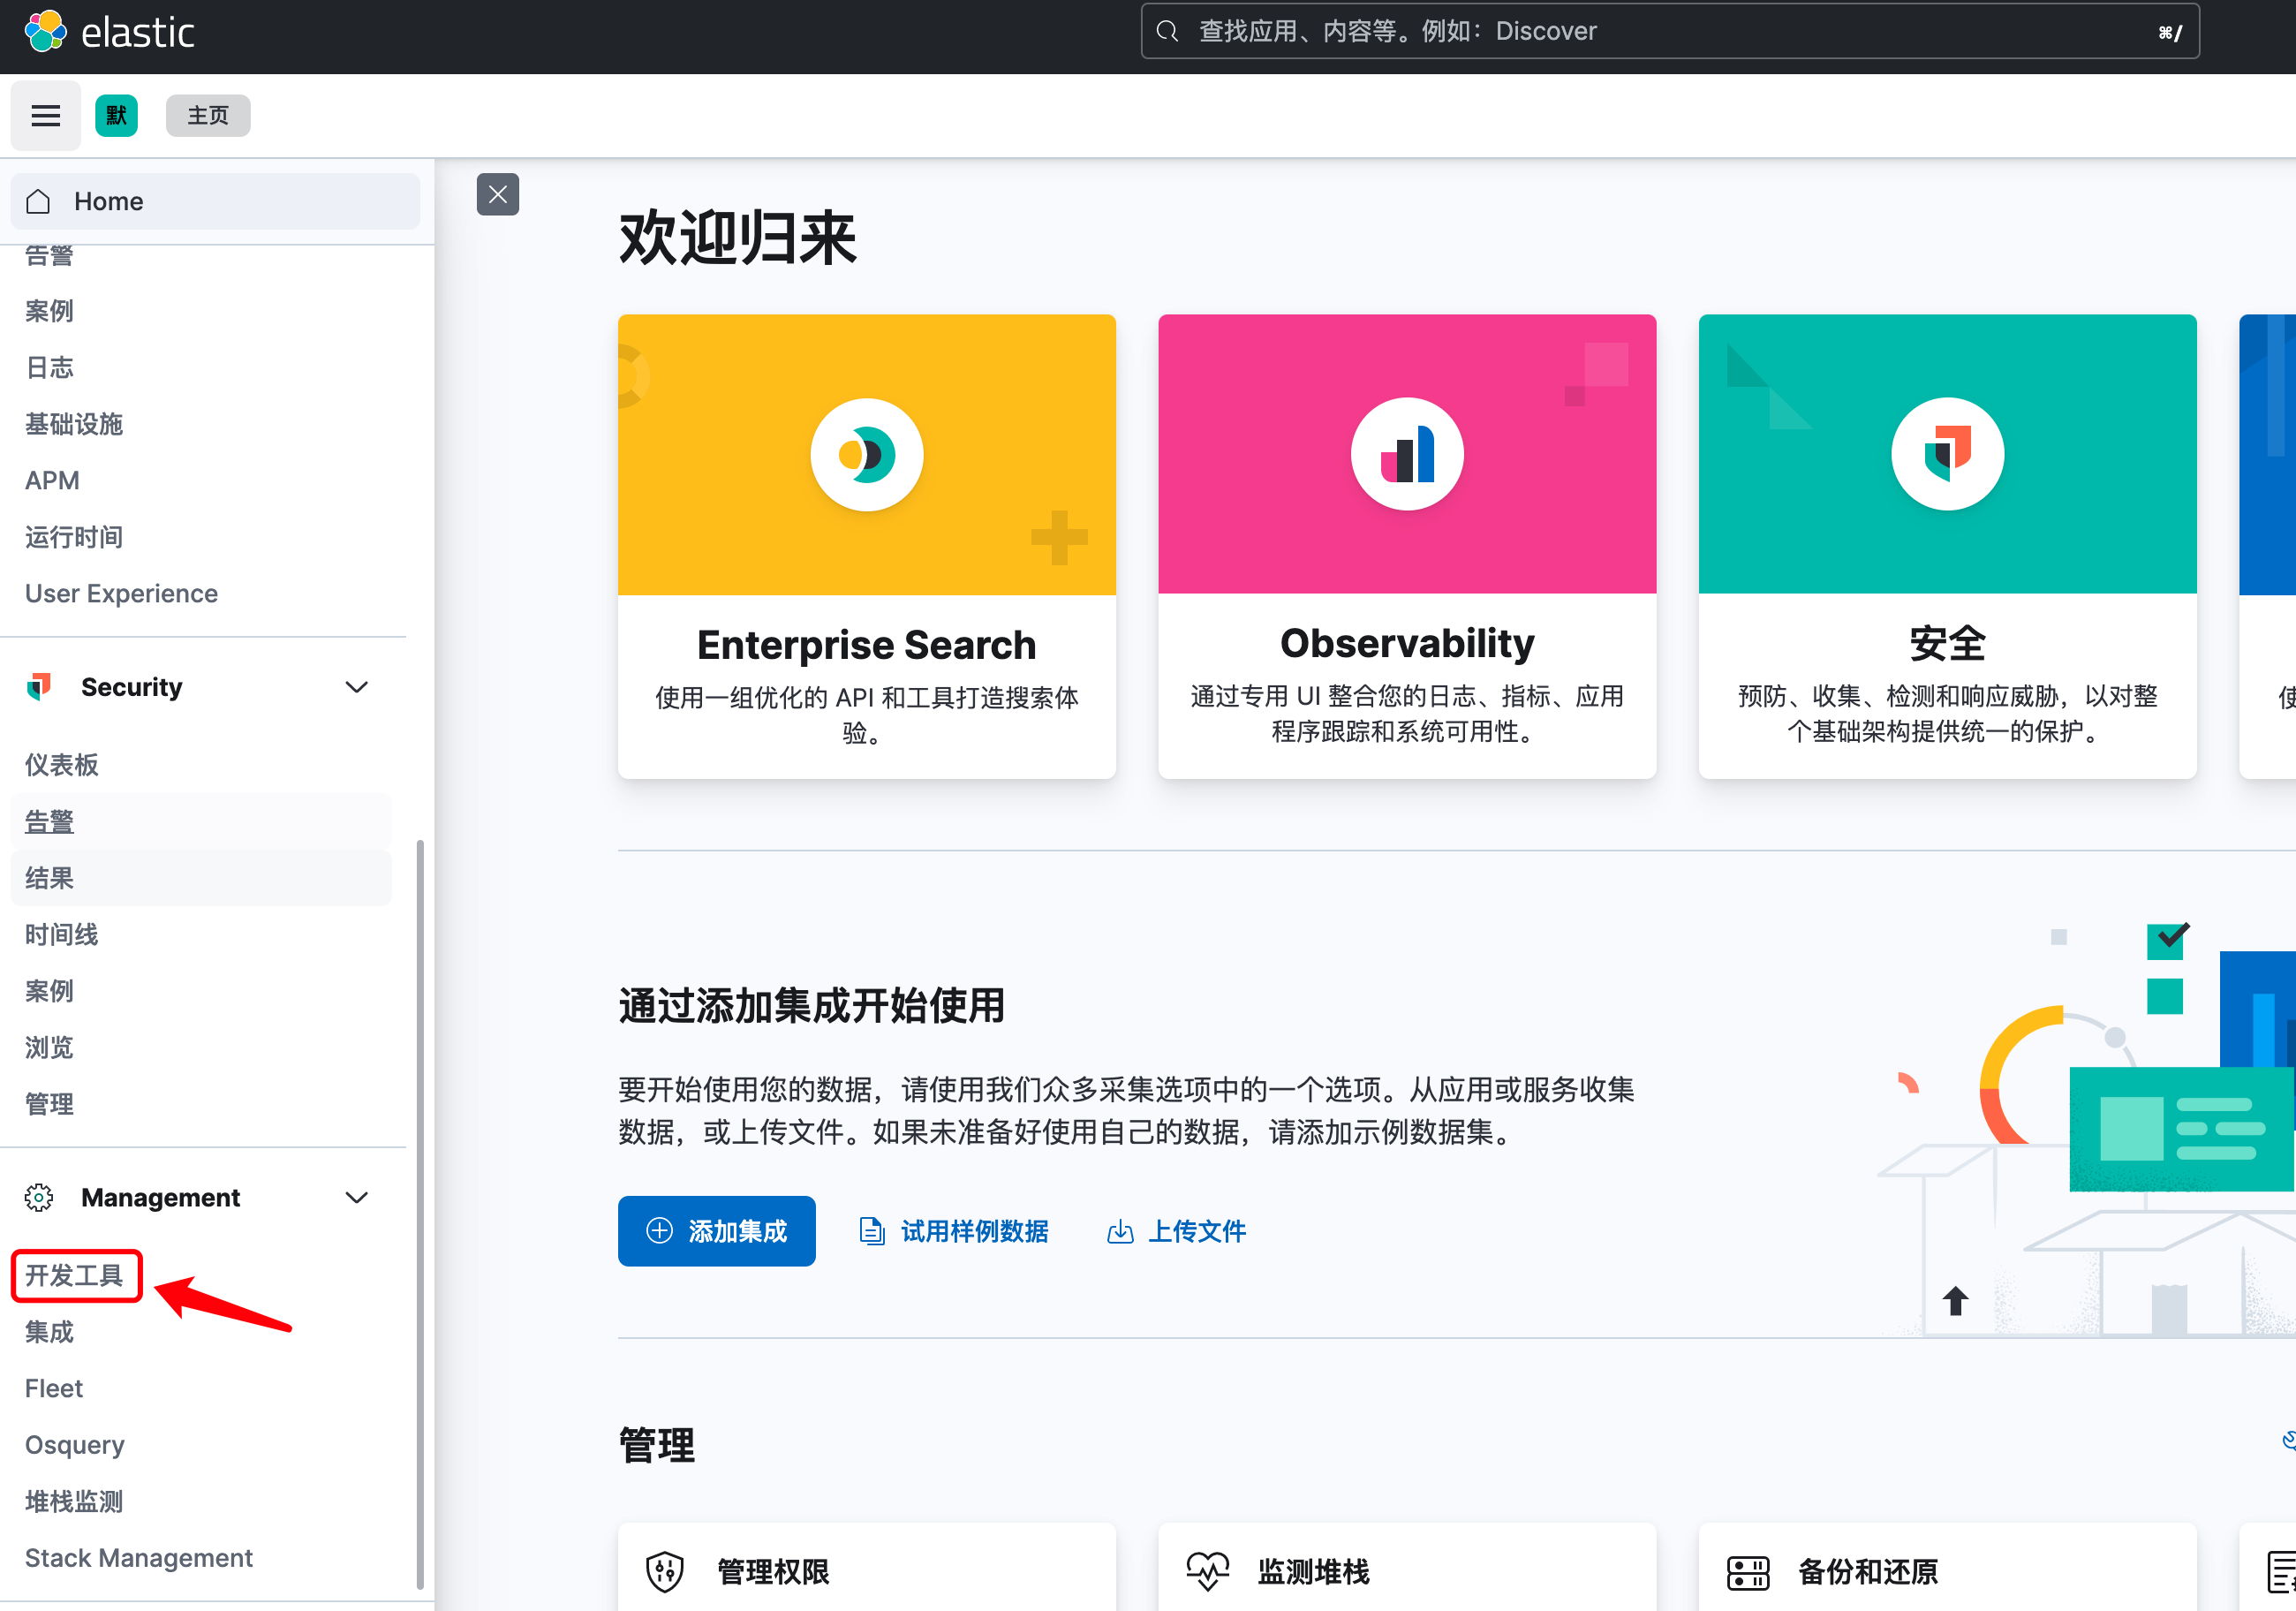
Kibana是 Elasticsearch 的开源分析可视化工具,与存储在 Elasticsearch 中的数据进行交互。后续操作都使用kibana的开发工具
基本概念
索引(index)
一个索引就是一个拥有几分相似特征的文档的集合。比如说,可以有一个客户数据的索引,一个产品目录的索引,一个订单数据的索引。
一个索引由一个名字来标识(必须全部是小写字母的),并且当我们要对这个索引中的文档进行索引、搜索、更新和删除的时候,都要使用到这个名字。
文档(Document)
- Elasticsearch是面向文档的,文档是所有可搜索数据的最小单位
- 日志文件中的日志项
- 一本电影的具体信息/一张唱片的详细信息
- 一个产品的具体描述
- 文档会被序列化成JSON格式,保存在Elasticsearch中
- JSON对象由字段组成
- 每个字段都有对应的字段类型(字符串/数值/布尔/日期/二进制/范围类型)
- 每个文档都有一个Unique ID
- 可以自己指定ID或者通过ES自动生成
- 一个文档包含了一系列字段,类似数据库中的一条记录
- JSON文档,格式灵活,不需要预先定义格式
- 字段类型可以指定或者通过ES自动推算
- 支持数组/支持嵌套
文档元数据
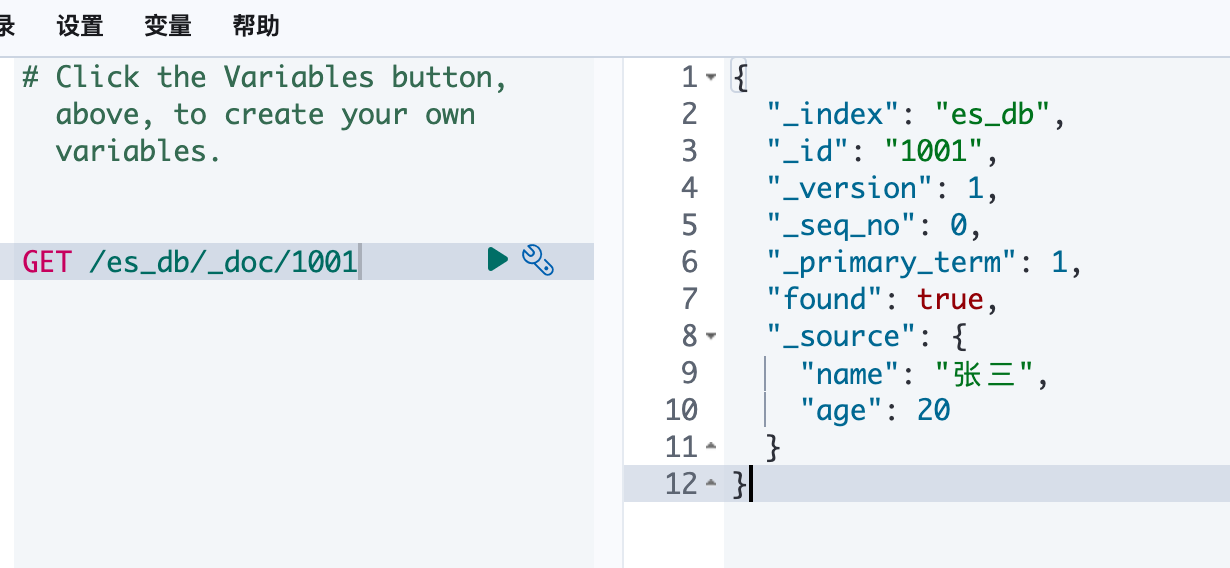
元数据,用于标注文档的相关信息:
- _index:文档所属的索引名
- _type:文档所属的类型名
- _id:文档唯一id
- _source:文档的原始json数据
- _version:文档的版本号,修改删除操作
_version都会自增1 - _seq_no:和verison一样,一旦数据发生更改,数据也一直是累计的。Shard级别严格递增,保证后写入的Doc的
_seq_no大于现写入的doc的seq_no - _primary_term:主要是用来恢复数据时处理当多个文档的
_seq_no相同时的冲突,避免Primary Shard上的写入被覆盖。每当Primary Shard发生重新分配时,比如重启,Primary选举等,_primary_term会递增1.
并发场景下修改文档
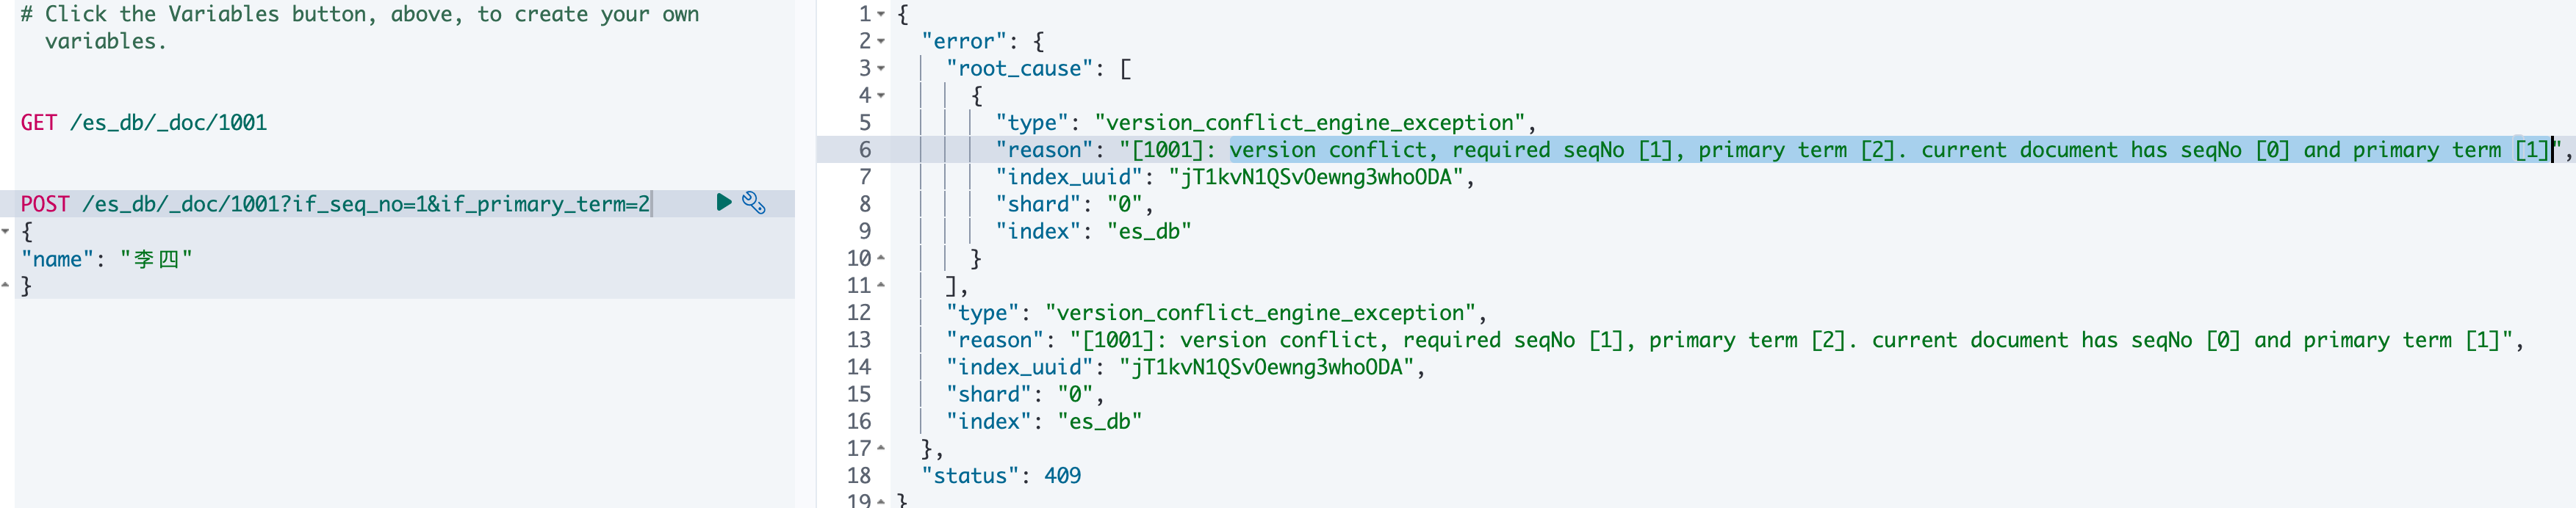
_seq_no和_primary_term是对version的优化,7.x版本的ES默认使用这种方式控制版本,所以当在高并发环境下使用乐观锁机制修改文档时,要带上当前文档的_seq_no和_primary_term进行更新:
POST /es_db/_doc/1001?if_seq_no=1&if_primary_term=2
{
"name": "李四"
}
如果版本号不对,会抛出版本冲突异常,如下图:
索引操作
创建索引
索引名字必须小写,不能以下划线开头
格式:PUT /索引名称
# 创建索引
PUT /es_db

# 创建索引时可以设置分片数和福本数
PUT /es_db
{
	"settings": {
		"number_of_shards": 3,
		"number_of_replicas": 2
	}
}

# 修改索引配置
PUT /es_db/_settings
{
	"index": {
		"number_of_replicas": 1
	}
}
查询索引
格式:GET/索引名称
# 查询索引
GET /es_db

# 判断es_db是否存在
HEAD /es_db
删除索引
格式: DELETE/索引名称
DELETE /es_db文档操作
添加文档
格式:[PUT | POST] /索引名称/[_doc | _create ]/id
# 创建文档,指定id
# 如果id不存在,创建新的文档,否则先删除现有文档,再创建新的文档,版本会增加
PUT /es_db/_doc/1001 #指定id为1001
{
	"name": "张三",
	"age": 18,
	"sex": "男",
	"address": "山东省济南市"
}

# 生成id
POST /es_db/_doc
{
	"name": "李四",
	"age": 22,
	"sex": "女",
	"address": "山东省滨州市"
}
注意:
- POST和PUT都能起到创建/更新的作用
- PUT需要对一个具体的资源进行操作也就是要确定id才能进行更新/创建
- POST是可以针对整个资源集合进行操作的,如果不写id就生成id,如果写了id那就针对这个id的文档进行创建/更新
_doc和_create都是创建文档的关键字- _doc创建文档时,可指定id,也可以不指定
- _create创建文档时,必须指定id,若id已经存在了,会失败。
修改文档
全量更新,整个json都会替换,格式:[PUT|POST] /索引名称/_doc/id,如果文档存在,现有文档会被删除,新文档会被索引。
# 全量更新,替换整个json
PUT /es_db/_doc/1001
{
	"name": "张三",
	"age": 18,
	"sex": "男"
}

#全量更新前数据
{
	"name": "张三",
	"age": 18,
	"sex": "男",
	"address": "山东省济南市"
}
# 更新后数据
{
	"name": "张三",
	"age": 18,
	"sex": "男"
}
使用update部分更新,格式: POST /索引名称/_update/id,updata不会删除原来的文档,而是实现真正的数据更新。
# 部分更新:在原有文档上更新
# Update -文档必须已经存在,更新只会对相应字段做增量修改
POST /es_db/_update/1
{
	"doc":{
		"age": 20
	}
}
# 更新前数据
{
	"name": "张三",
	"age": 18,
	"sex": "男"
}
# 更新后数据
{
	"name": "张三",
	"age": 20,
	"sex": "男"
}使用_update_by_query更新文档,格式:POST /索引名称/_update_by_query
POST /es_db/_update_by_query
{
	"query": {
		"match": {
			"_id": 1
		}
	},
	"script": {
		"source": "ctx._source.age = 30"
	}
}
# 更新后数据
{
	"name": "张三",
	"age": 30,
	"sex": "男"
}
查询文档
根据id查询文档,格式:GET /索引名称/_doc/id
GET /es_db/_doc/1001条件查询search, 格式: GET /索引名称/_search
# 查询前10条文档
GET /es_db/_doc/_search
ES 提供了两种条件查询搜索方式
- REST风格的请求URI,直接将参数带过去
- 封装到 body中,这种方式可以定义更加易读的json格式
# 通过URI搜索,使用“q”指定查询字符串,“query string syntax” KV健值对

# 条件查询,查询age等于18岁的,格式:_search?q=age:18
GET /es_db/_doc/_search?q=age:18

# 范围查询,查询age在18至28之间的 格式_search?q=age[18 TO 28] 注意:TO必须大写
GET /es_db/_doc/_search?q=age[18 TO 28]

# 查询age 小于等于18的 格式 age:<=18
GET /es_db/_doc/_search?q=age:<=18

# 查询年龄大雨18的 格式 age:>18
GET /es_db/_doc/_search?q=age:>18

# 分页查询 from=0&size=10
GET /es_db/_doc/_search?age:>18&from=0&size=10

# 对查询结果只输出某些字段 _source=字段,字段
GET /es_db/_doc/_search?_source=name,age

# 对查询结果排序 sort=字段:desc/asc
GET /es_db/_doc/_search?sort=age:desc
删除文档
格式:DELETE /索引名称/_doc/id
DELETE /es_db/_doc/1