ES检索原理分析
索引的原理
索引是加速数据查询的重要手段,其核心原理是通过不断的缩小想要获取数据的范围来筛选出最终想要的结果,同时把随机的事件变成顺序的事件。
磁盘IO与预读
磁盘IO是程序设计中非常高昂的操作,也是影响程序性能的重要因素,因此应当尽量避免过多的磁盘IO,有效的利用内存可以大大的提升程序的性能。在操作系统层面,发生一次IO时,不光把当前磁盘地址的数据,而是把相邻的数据也都读取到内存缓冲区内,局部预读性原理告诉我们,当计算机访问一个地址的数据的时候,与其相邻的数据也会很快被访问到。每一次IO读取的数据我们称之为一页(page)。具体一页有多大数据跟操作系统有关,一般为4k或8k,也就时我盟读取一页内的数据时候,实际上才发生了一次IO,这个理论对于索引的数据结构设计非常有帮助。
ES倒排索引
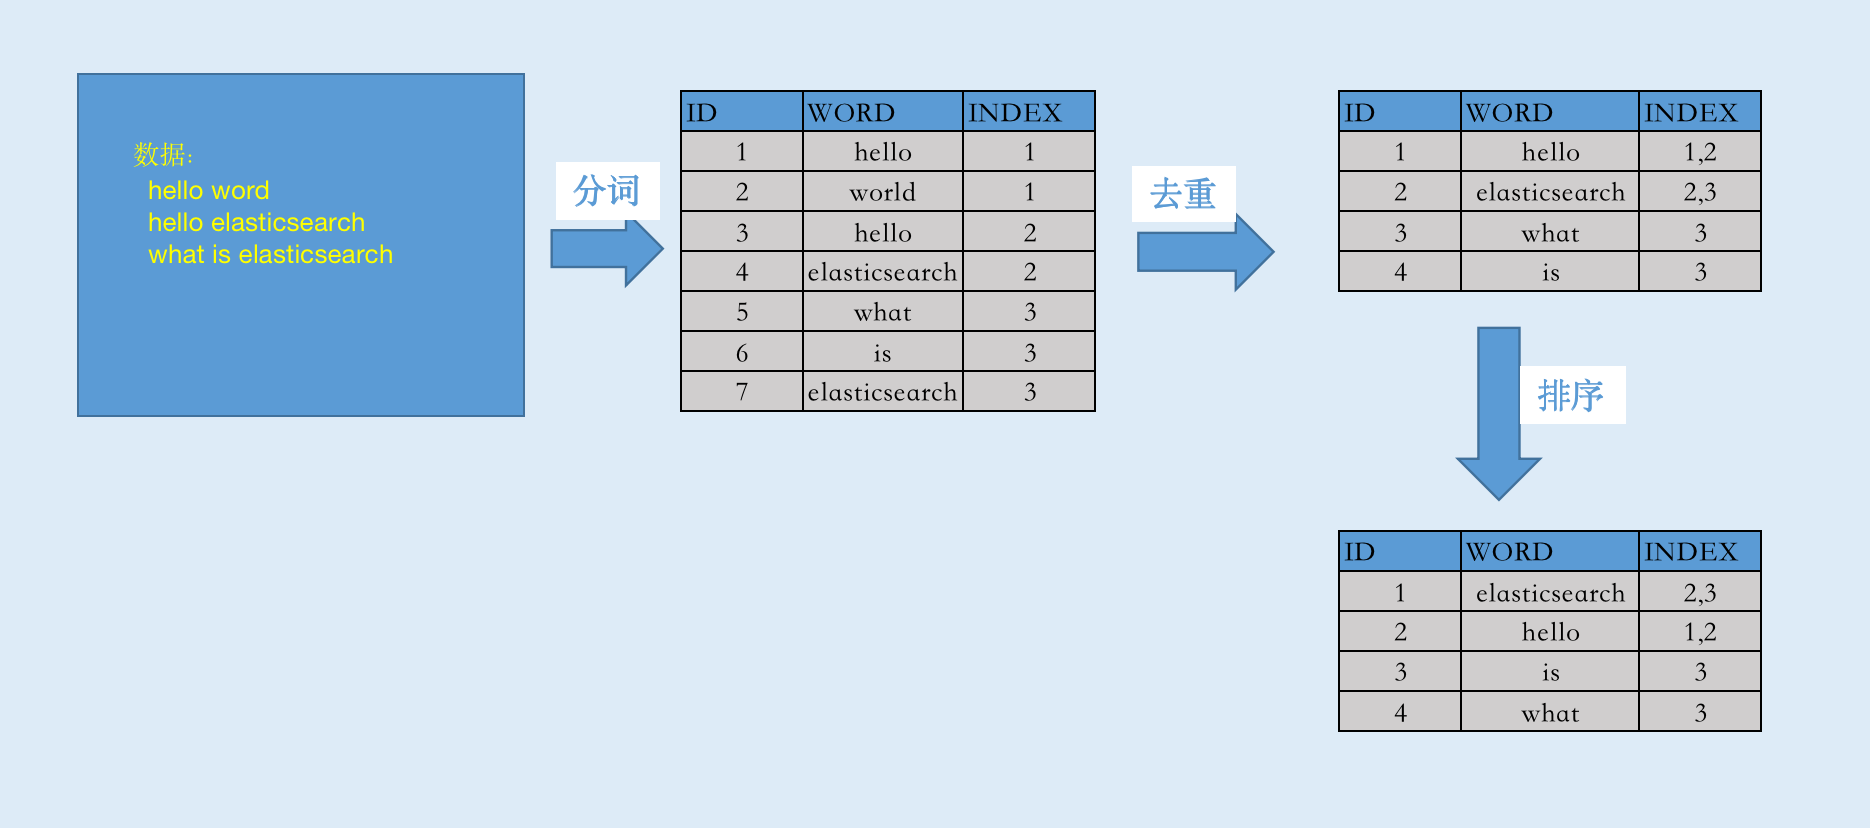
当数据写入ES时,数据将会通过分词被切分为不同的term,ES将term与其对应的文档列表建立一种映射关系,这种结构就是倒排索引。如下图所示:
为了进一步提升索引的效率,ES在term的基础上利用term的前缀或者后缀构建了term index,用于对term本身进行索引,ES实际的索引结构如下图所示:
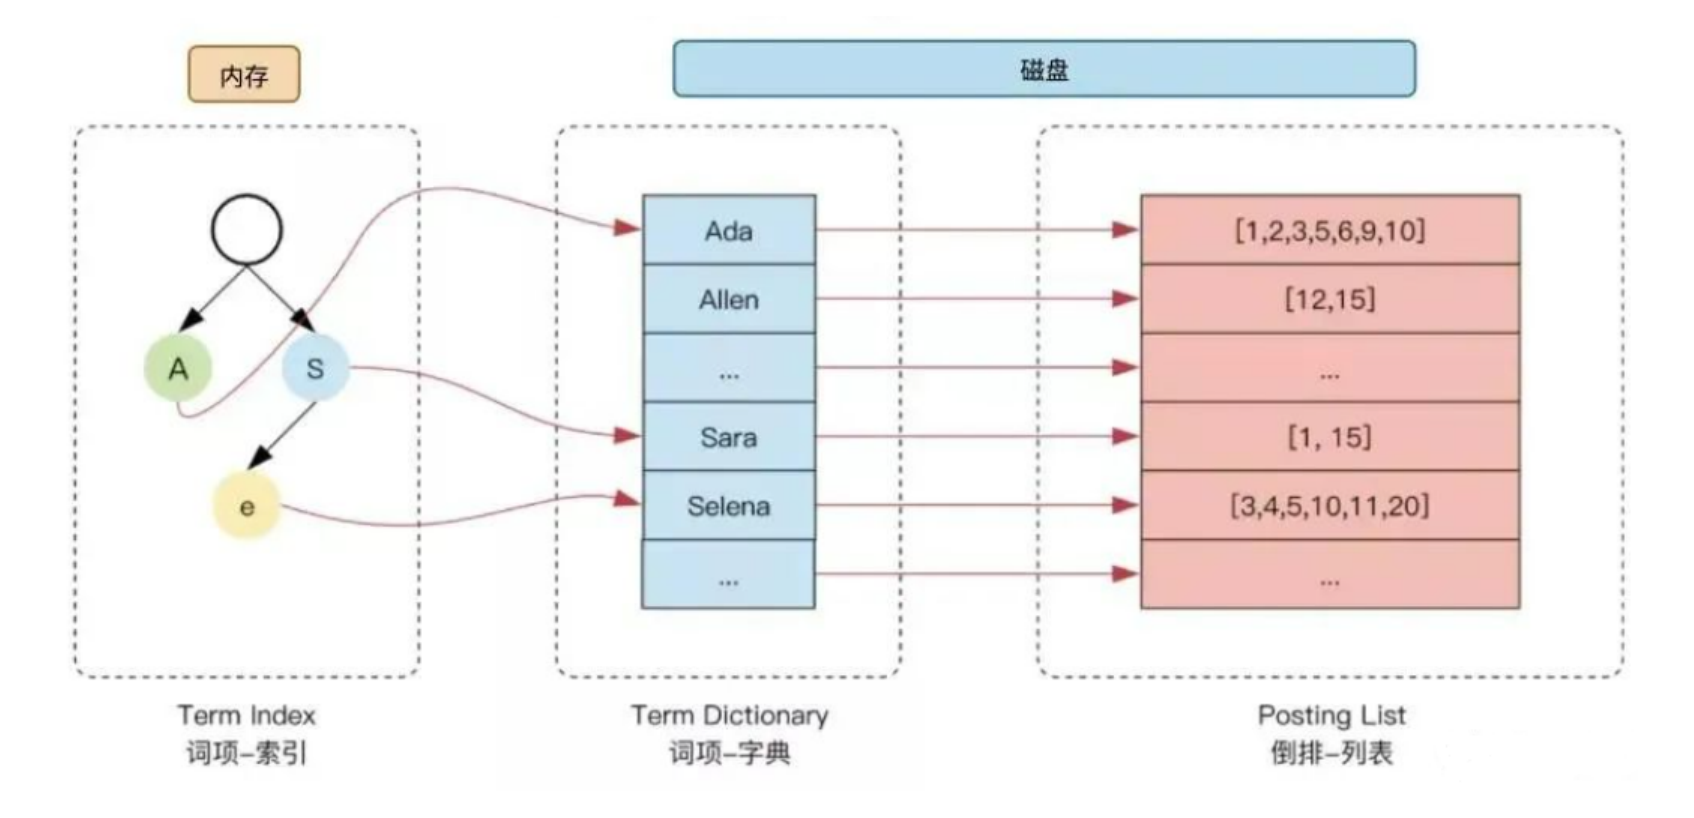
这样当我们去搜索某个关键词时,ES首先根据它的前缀或者后缀迅速缩小关键词在term dictionary中的范围,大大减小了磁盘IO的次数。
- 单词词典(term dictionary):记录所有文档的单词,记录单词到倒排列表的关联联系
- 倒排列表(posting list):记录了单词对应的文档结合,由倒排索引项组成
- 倒排索引项(posting):
- 文档id
- 词频TF-该单词在文档中出现的次数,用于相关性评分
- 位置(position)-单词在文档中分词的位置。用于短语搜索(match phrase query)
- 偏移(offset)-记录单词的开始结束位置,实现高亮显示