高级查询
ES 高级查询 QueryDSL
ES 中提供了一种强大的检索数据的方式,这种检索方式称之为 Query DSL(Domain Specified Language),Query DSL 是利用 Rest API 传递 JSON 格式的请求体(RequestBody)数据与 ES 进行交互,这种方式的丰富查询语法让 ES 检索变得更强大,更简洁。
https://www.elastic.co/guide/en/elasticsearch/reference/8.4/query-dsl.html
语法:
GET /es_db/_doc/_search {json请求体数据}
# 可以简化为下面写法
GET /es_db/_search {json请求体数据}
示例数据
// 指定ik分词器
PUT /es_db
{ "settings" : { "index" : { "analysis.analyzer.default.type": "ik_max_word" } } }
// 创建文档,指定id
PUT /es_db/_doc/1
{"name": "张三", "sex": 1, "age": 18, "address": "山东济南", "remark": "java developer" }
PUT /es_db/_doc/2
{"name": "李四", "sex": 1, "age": 22, "address": "山东省滨州市", "remark": "java" }
PUT /es_db/_doc/3
{"name": "王五", "sex": 0, "age": 33, "address": "山东济南大明湖", "remark": "php" }
PUT /es_db/_doc/4
{"name": "赵六", "sex": 0, "age": 20, "address": "山东济南千佛山公园", "remark": "python" }
PUT /es_db/_doc/5
{"name": "张龙", "sex": 0, "age": 17, "address": "济南趵突泉", "remark": "golang" }
PUT /es_db/_doc/6
{"name": "赵虎", "sex": 1, "age": 32, "address": "荣盛时代国际", "remark": "vue" }
查询所有 match_all
使用 match_all,默认只会返回 10 条数据。
原因:_search 查询默认采用的是分页查询,每页记录数 size 的默认值是 10。如果想显示更多数据,需指定 size
GET /es_db/_search

// 等同于
GET /es_db/_search
{
  "query":{
    "match_all":{}
  }
}
返回指定条数 size
size 关键字:指定查询结果中返回指定条数。默认返回值 10 条
GET /es_db/_search
{
  "query":{
    "match_all":{}
  },
  "size":100
}
分页查询 from
from 关键字:用来指定起始返回位置,和 size 关键字连用可实现分页效果
GET /es_db/_search
{
  "query":{
    "match_all":{}
  },
  "size":10,
  "from":10
}
思考:size 可以无限增加吗?
测试
GET /es_db/_search
{
  "query":{
    "match_all":{}
  },
  "size":20000
}
结果出现异常:
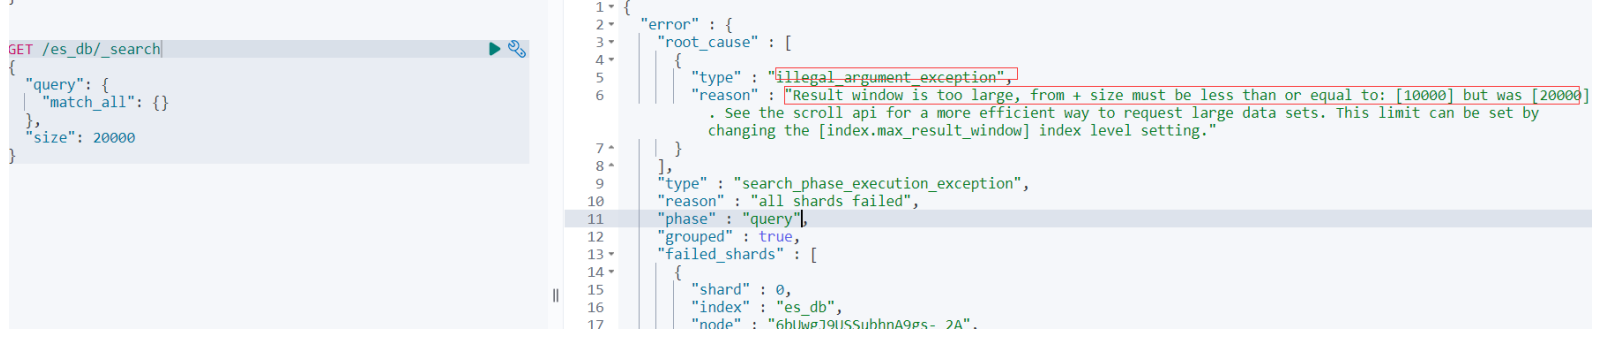
异常原因:
- 查询结果的窗口太大,from+size 的结果必须小于或等于 10000,而当查询结果的窗口为 20000。
- 可以采用 scroll api 更高效的请求大量数据集。
- 查询结果的窗口的限制可以通过参数 index.max_result_window 进行设置。
// 修改指定索引
PUT /es_db/_settings
{ "index.max_result_window":"20000"}

// 修改现有所有的索引,但是新增的索引,还是默认的10000
PUT /_all/_settings
{ "index.max_result_window":"20000"}

// 查看所有索引中的index.max_result_window值
GET /es_db/_settings/index.max_result_window
注意
参数 index.max_result_window 主要用来显示单次查询满足查询条件的结果窗口的大小,窗口大小由 from+size 共同决定。不能简单理解成查询返回给调用方的数据量。这样做主要是为了限制内存的消耗。
比如:from 为 1000000,size 为 10,逻辑意义是从满足条件的数据中取 1000000 到(1000000+10)的记录。这时 ES 一定要先将(1000000+10)的记录(即 result_window)加载到内存中,再进行分页取值的操作。尽管最后我们只取到了 10 条数据返回给客户端,单 ES 进程执行查询的过程中需要将(1000000+10)的记录都加载到内存中,可想而知对内存消耗有多大。这也是 ES 中不推荐采用(from+size)方式进行深度分页的原因。
同理,from 为 0,size 为 1000000 时,ES 进程执行查询操作的过程中的确需要将 1000000 记录都加载到内存中再返回给调用方,也会对 ES 内存造成很大的压力。
分页查询 Scroll
改动 index.max_result_window 参数值的大小,只能解决一时的问题,当索引的数据量持续增长时,在查询全量数据时还是会出现问题。而且会增加 ES 服务器的内存消耗完的风险。最佳实践还是根据异常提示中的采用 scroll api 更高效的请求大量数据集。
// 查询命令中新增scroll=1m,说明采用游标查询,保持游标查询窗口一分钟。
// 这里由于测试数据量不够,所以size值设置为2.
// 实际使用中为了减少游标查询的次数,可以将值适当增大,比如设置为1000。
GET /es_db/_search?scroll=1m
{
	"query":{"match_all":{}},
	"size":2
}
查询结果:
除了返回前 2 条,还返回了一个游标 ID 值_scroll_id。
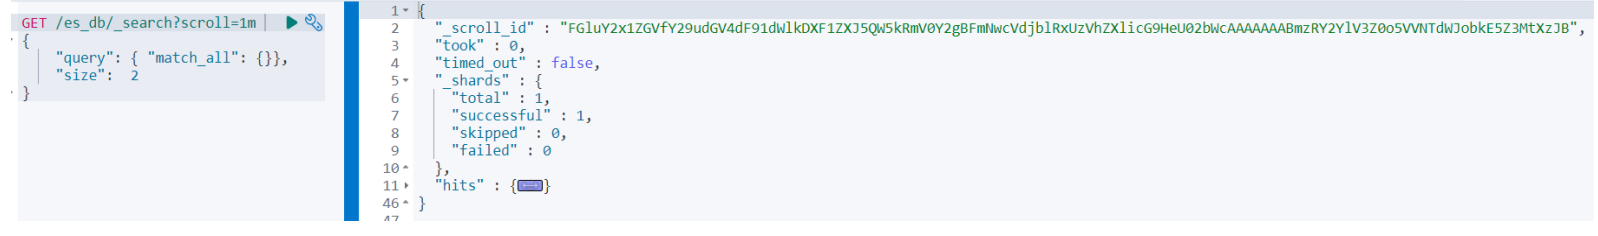
采用游标 id 查询:
// scroll_id 的值就是上一个请求中返回的 _scroll_id 的值
GET /_search/scroll
{
  "scroll": "1m",
  "scroll_id" : "FGluY2x1ZGVfY29udGV4dF91dWlkDXF1ZXJ5QW5kRmV0Y2gBFmNwcVdjblRxUzVhZXlicG9HeU02bWcAAAAAAABmzRY2YlV3Z0o5VVNTdWJobkE5Z3MtXzJB"
}
多次根据 scroll_id 游标查询,直到没有数据返回则结束查询。采用游标查询索引全量数据更安全高效,限制了单次对内存的消耗。
指定字段排序 sort
注意:会让得分排序失效
GET /es_db/_search
{
  "query":{
    "match_all":{}
  },
  "sort":[
    {
      "age":"desc"
    }
    ]
}

// 排序 分页
GET /es_db/_search
{
  "query":{
    "match_all":{}
  },
  "sort":[
    {
      "age":"desc"
    }
    ],
  "from":10,
  "size":10
}
返回指定字段_source
_source 关键字:是一个数组中用来指定展示那些字段
GET /es_db/_search
{
  "query":{
    "march_all":{}
  },
  "_source":["name","age"]
}
match
match 在匹配时会对所查找的关键词进行分,然后按分词匹配查找
match 支持以下参数:
- query:指定匹配的值
- operator: 匹配条件类型
- and:条件分词后都要匹配
- or:条件分词后有一个匹配即可
- minmum_should_match:最低匹配度,即条件在倒排索引中最低的匹配度
// 模糊匹配 match 分词后or的效果
GET /es_db/_search
{
  "query":{
    "match":{
      "address":"山东济南"
    }
  }
}

// 分词后 and的效果
GET /es_db/_search
{
  "query":{
    "match":{
      "address":{
        "query":"山东济南",
        "operator":"AND"
      }
    }
  }
}
在 match 中的应用:当 operator 参数主;设置为 or 时,minmum_should_match 参数用来控制匹配的分词的最少数量。
// 最少匹配山东,济南两个词
GET /es_db/_search
{
  "query":{
    "match":{
      "address":{
        "query":"山东济南",
        "minmum_should_match":2
      }
    }
  }
}
短语查询 match_phrase
match_phrase 查询分析文本并根据分析的文本创建一个短语查询。match_phrase 会将检索关键词分词。match_phrase 的分词结果必须在被检索字段的分词中都包含,而且顺序必须相同,而且默认必须都是连续的。
GET /es_db/_search
{ "query": { "match_phrase": { "address": "山东济南千佛山" } } }
GET /es_db/_search
{ "query": { "match_phrase": { "address": "山东济南千" } } }
注意
查询山东济南千佛山有数据。
查询山东济南千没有数据。
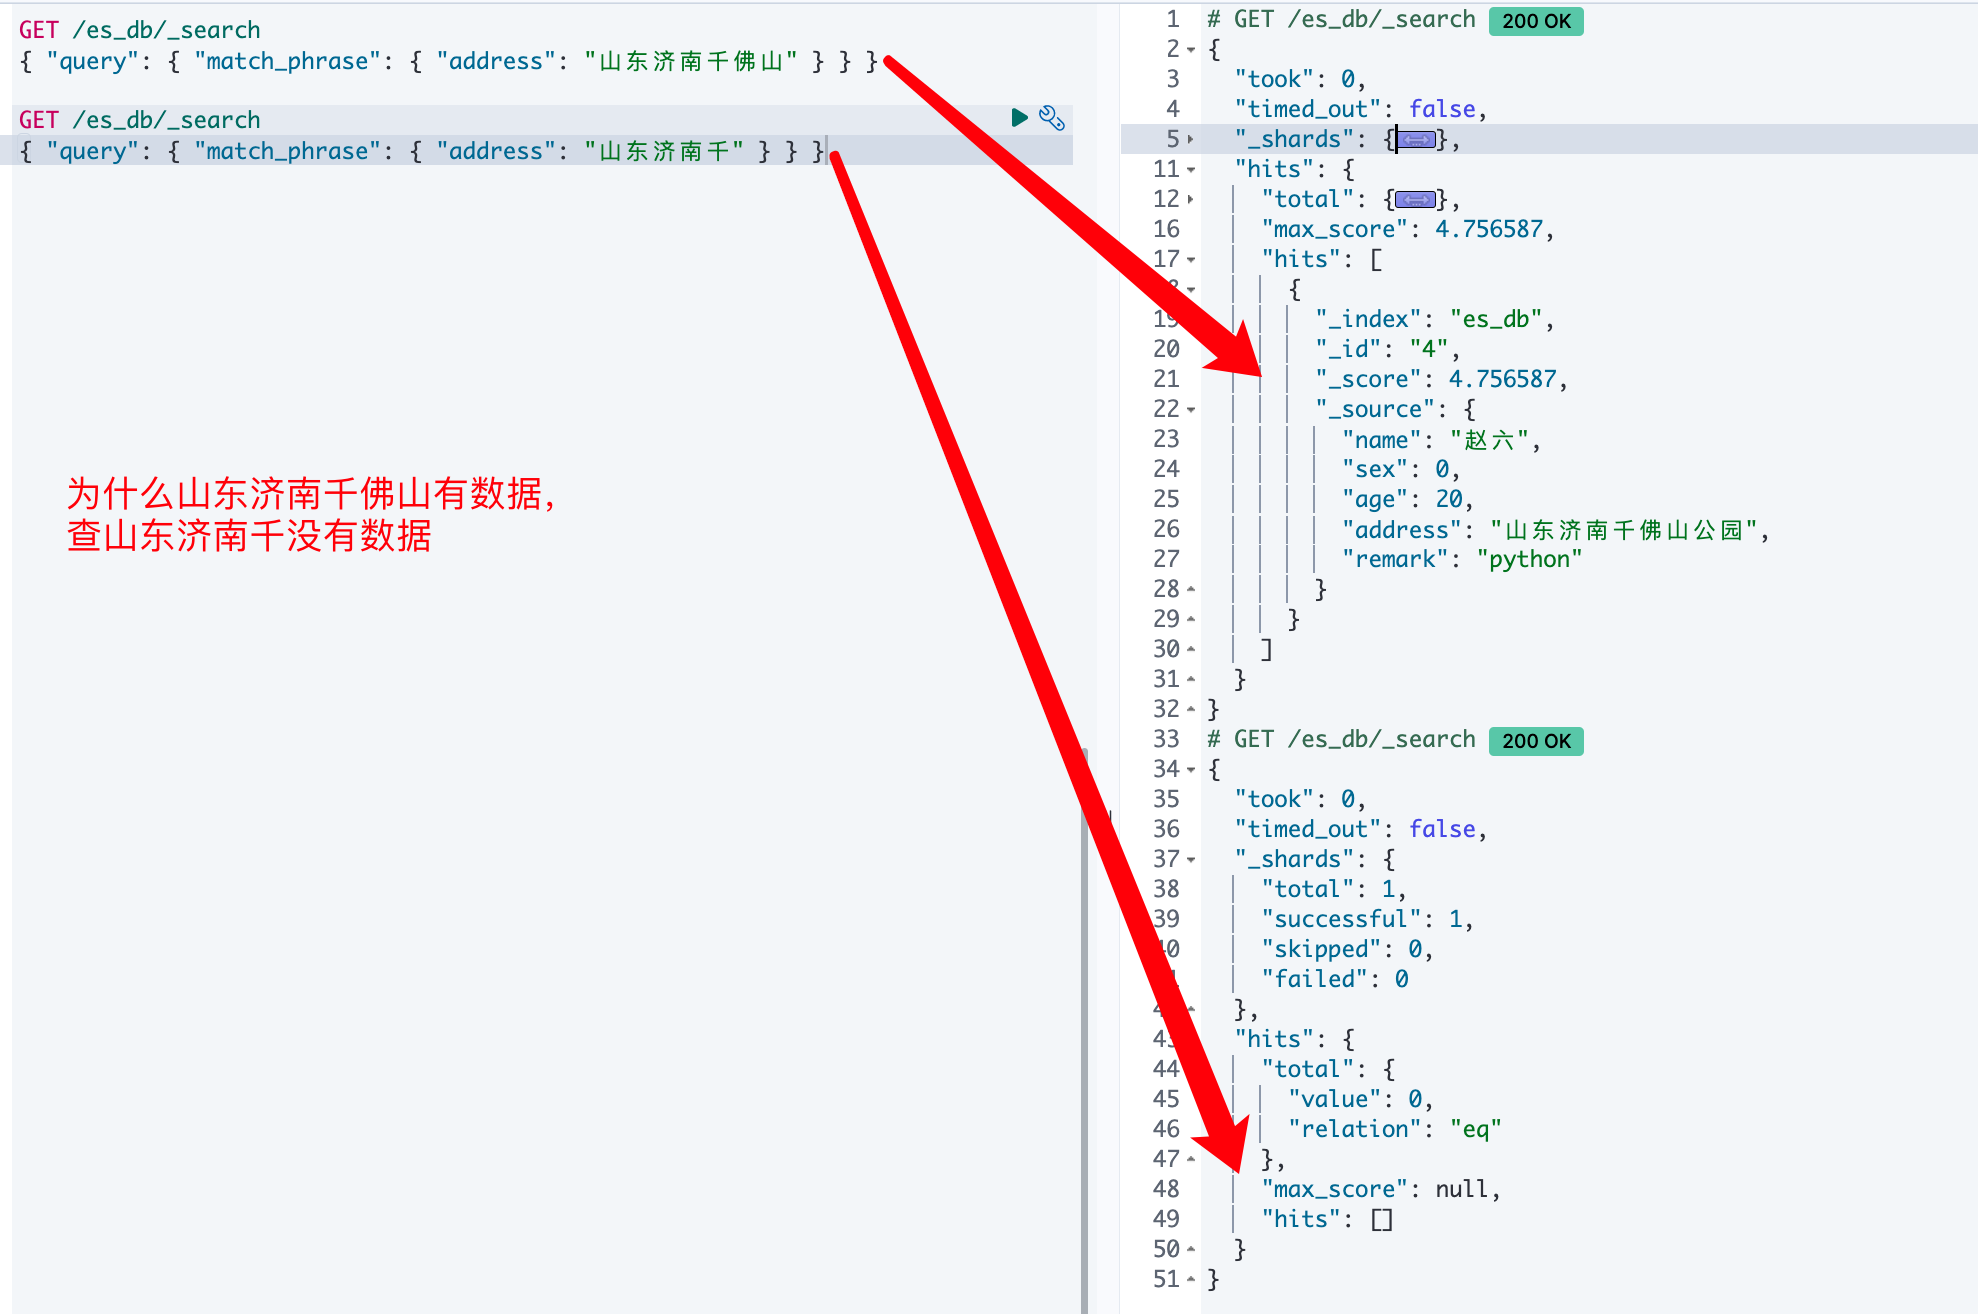
分析原因:
先查看山东济南千佛山公园分词结果,可以知道山东济南和千不是相邻的词条,中间会隔一个千佛山,而 match_phrase 匹配的是相邻的词条,所以查询山东济南千没有结果。
POST _analyze
{ "analyzer":"ik_max_word", "text":"山东济南千佛山" }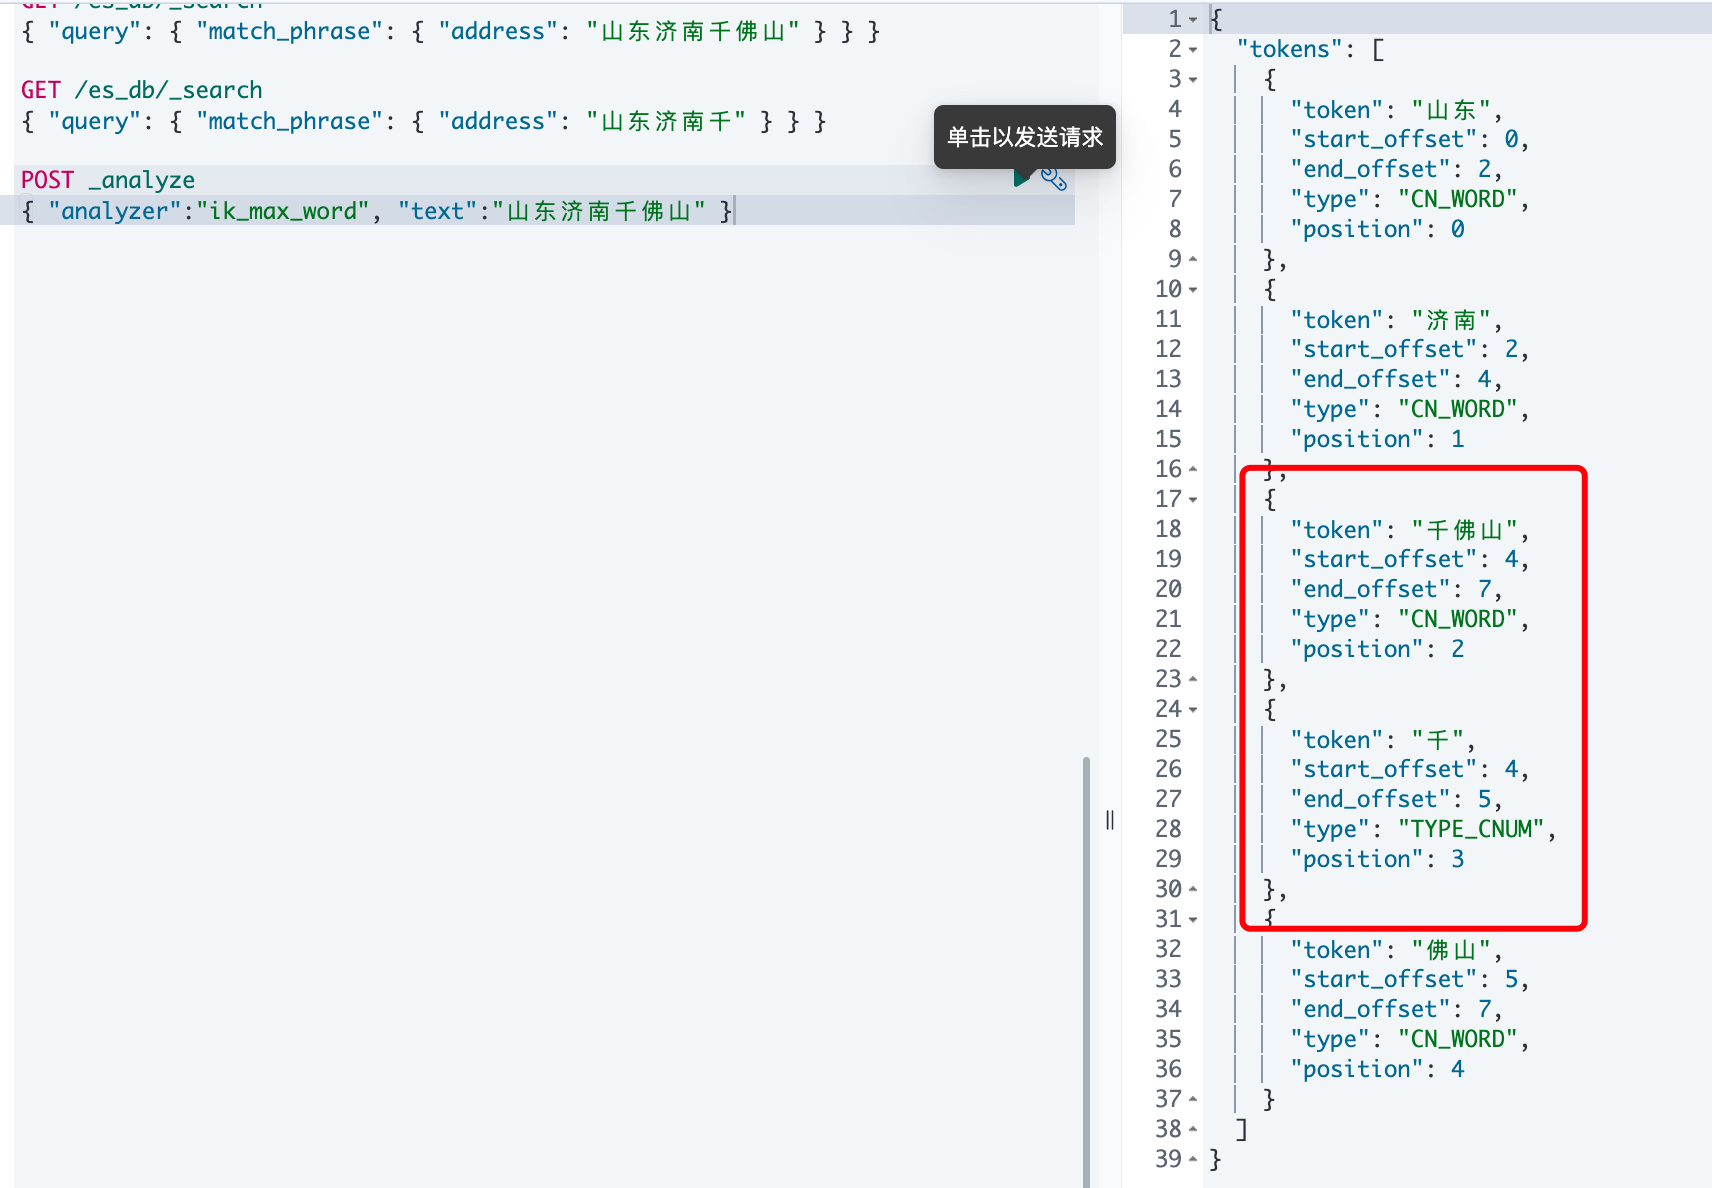
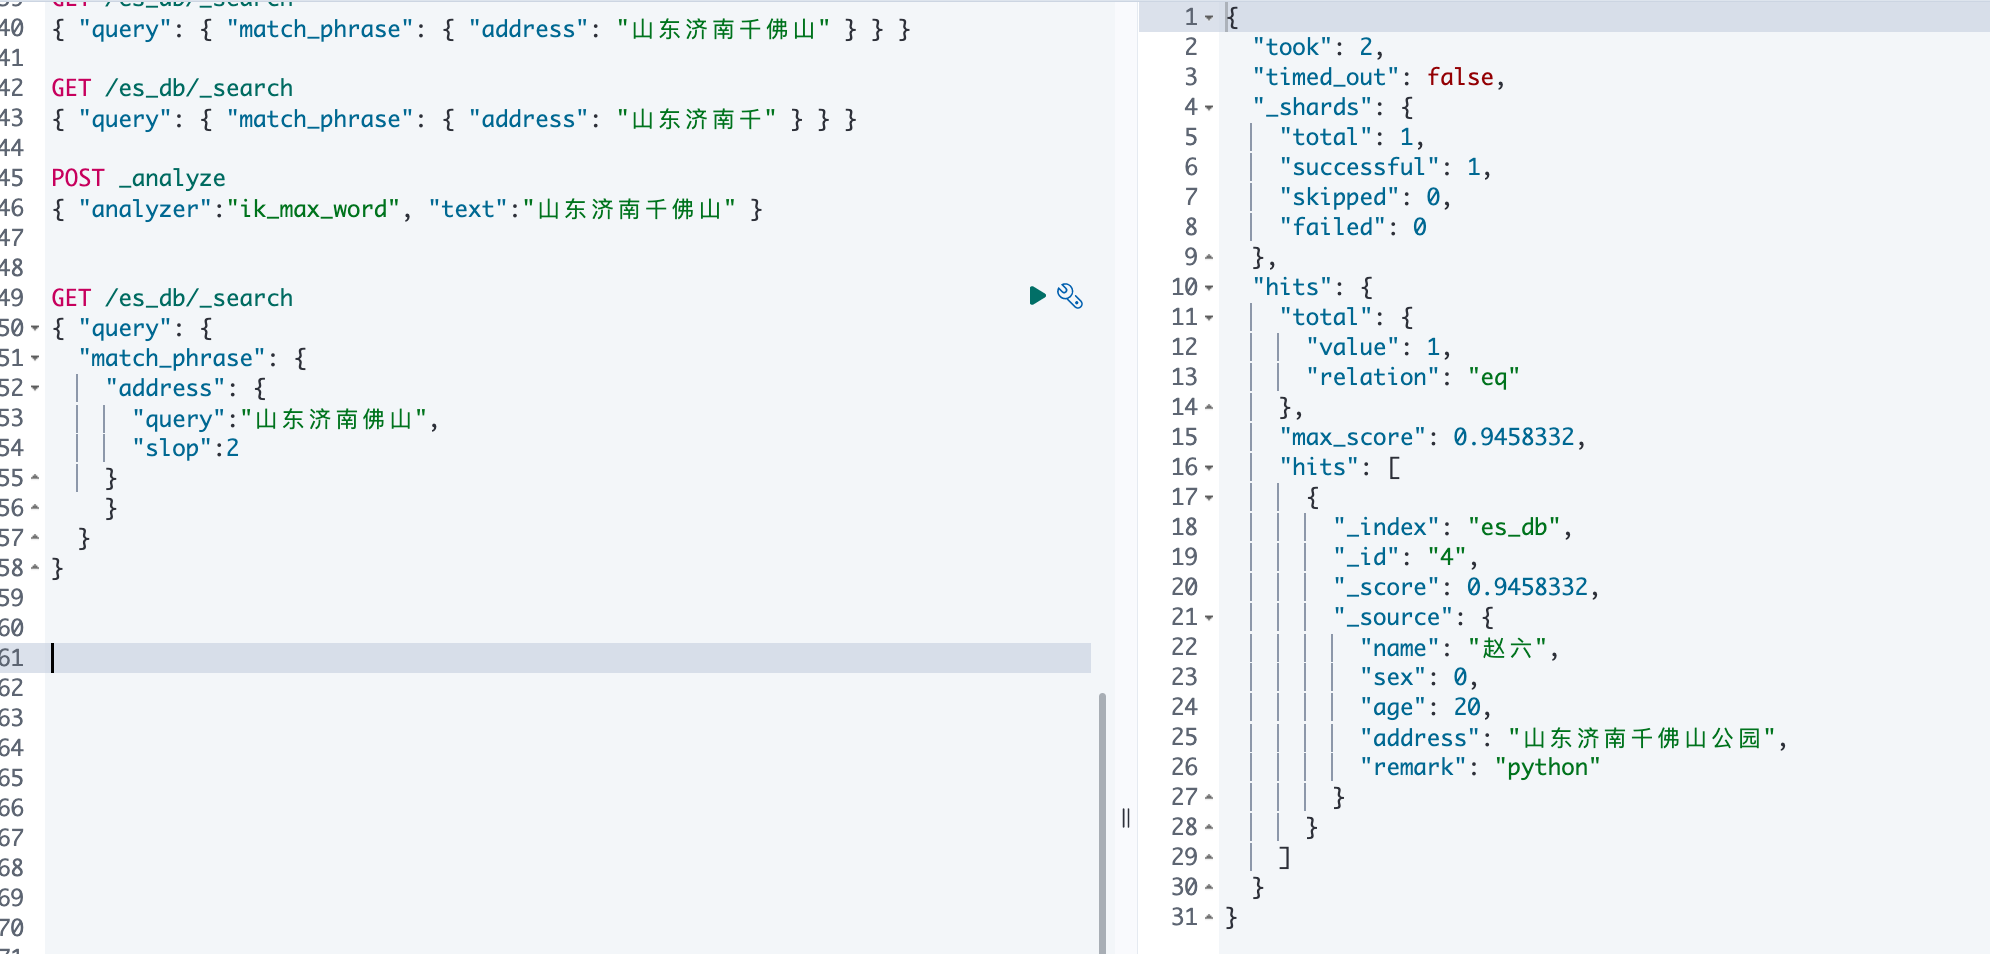
如何解决词条间隔的问题?可以借助 slop 参数告诉 match_phrase 查询词条能够相隔多远时仍然将文档视为匹配。
// 山东济南佛山分词后相隔为2,可以匹配到结果
GET /es_db/_search
{ "query": {
  "match_phrase": {
    "address": {
      "query":"山东济南佛山",
      "slop":2
    }
  	}
	}
}
多字段查询 multi_match
可以根据字段类型,决定是否使用分词查询,得分最高的在前面
GET /es_db/_search
{
  "query":{
    "multi_match":{
      "query":"千佛山张三",
      "fields":[
        "address",
        "name"
      ]
    }
  }
}
注意
字段类型分词,将查询条件分词之后进行查询,如果该字段不分词就会将查询条件作为整体进行查询
query_string
允许我们在单个查询字符串中指定 AND | OR | NOT 条件,同时也和 multi_match query 一样,支持多字段搜索。和 match 类似,但是 match 需要指定字段名,query_string 是在所有字段中搜索,范围更广泛。
注意
查询字段分词就将查询条件分词查询,查询字段不分词将查询条件不分词查询
未指定字段查询
jsonGET /es_db/_search { "query":{ "query_string":{ "query": "张三 OR 千佛山" } } }指定单个字段查询
jsonGET /es_db/_search { "query":{ "query_string":{ "default_field":"address", "query":"张三 OR 千佛山" } } }指定多个字段查询
jsonGET /es_db/_search { "query":{ "query_string":{ "fields":["name", "address"], "query": "张三 OR 千佛山" } } }
simple_query_string
类似 query_string,但是会忽略错误的语法,同时只支持部分查询语法,不支持 AND OR NOT, 会当作字符串处理。支持部分逻辑:
+替代 AND|替代 OR-替代 NOT
// simple_query_string 默认的operator是OR
GET /es_db/_search
{
  "query": {
    "simple_query_string":{
      "fields":["name","address"],
      "query":"张三千佛山",
      "default_operator": "AND"
    }
  }
}

GET /es_db/_search
{
  "query":{
    "simple_query_string":{
      "fields":["name", "address"],
      "query": "张三+千佛山"
    }
  }
}
关键词查询 Term
Term 用来使用关键词查询(精确匹配),还可以用来查询没有被进行分词的数据类型。Term 是表达语意的最小单位,搜索和利用统计语言模型进行自然语言处理都需要处理 Term。match 在匹配时会对所查找的关键词进行分词,然后按分词匹配查找,而 term 会直接对关键词进行查找。一般模糊查找的时候,多用 match,而精确查找时可以使用 term。
- ES 中默认使用分词器为标准分词器(StandardAnalyzer),标准分词器对于英文单词分词,对于中文单字分词。
- 在 ES 的 Mapping Type 中 Keyword, date, integer, long, double, boolean or ip 这些类型不分词,只有 text 类型分词。
// 关键词查询 term
// 思考:查询山东济南是否有数据,为什么?
GET /es_db/_search
{ "query":{ "term": { "address": { "value": "山东济南" } } } }

// 采用term精确查询,查询字段映射类型为 keyword
GET /es_db/_search
{ "query":{ "term": { "address.keyword": { "value": "山东济南" } } } }
在 ES 中,Term 查询,对输入不做分词。会将输入作为一个整体,在倒排索引中查找准确的词项,并且使用相关度算分公式为母个包含该词项的文档进行相关度算分。
PUT /product/_bulk
{"index":{"_id":1}}
{"productId":"1", "productName":"iPhone"}
{"index":{"_id":2}}
{"productId":"1", "productName":"iPad"}

// 思考:查询iPhone可以查到数据吗?
GET /product/_search
{
  "query":{
    "term":{
      "productName":{
        "value":"iPhone"
      }
    }
  }
}

GET /product/_analyze
{
  "analyzer":"standard",
  "text":"iPhone"
}
可以通过 Constant Score 将查询转换成一个 Filtering,避免算分,并利用缓存,提高性能。
- 将 Query 转成 Filter,忽略 TF-IDF 计算,避免相关性算分的开销
- Filter 可以有效利用缓存
GET /es_db/_search
{
  "query":{
    "constant_score":{
      "filter":{
        "term":{
          "address.keyword":"山东济南"
        }
      }
    }
  }
}
term 应用场景:对 bool,日期,数字,结构化的文本可以利用 term 做精确匹配
GET /es_db/_search
{
  "query":{
    "term":{
      "age":{
        "value":28
      }
    }
  }
}
term 处理多值字段,term 查询是包含,不是等于
POST /employee/_bulk
{"index":{"_id":1}}
{"name":"小明","interest":["跑步","篮球"]}
{"index":{"_id":2}}
{"name":"小红","interest":["跳舞","画画"]}
{"index":{"_id":3}}
{"name":"小丽","interest":["跳舞","唱歌","跑步"]}

POST /employee/_search
{
  "query":{
    "term":{
      "interest.keyword":{
        "value":"跑步"
      }
    }
  }
}
prefix 前缀搜索
它会对分词后的 term 进行前缀搜索。
- 它不会分析要搜索字符串,传入的前缀就是想要查找的前缀
- 默认状态下,前缀查询不做相关度分数计算,它只是将所有匹配的文档返回,然后赋予所有相关分数值为 1 。它的行为更像是一个过滤器而不是查询。两者实际的区别就是过滤器是可以被缓存的,而前缀查询不行。
prefix 的原理:需要遍历所有倒排索引,并比较每个 term 是否已所指定的前缀开头。
GET /es_db/_search
{
  "query":{
    "prefix":{
      "address":{
        "value":"山东济南"
      }
    }
  }
}
通配符查询 wildcard
通配符查询:工作原理和 prefix 相同,只不过它不是只比较开头,它能支持更为复杂的匹配模式。
GET /es_db/_search
{
  "query":{
    "wildcard":{
      "address":{
        "value":"*济*"
      }
    }
  }
}
范围查询 range
- range:范围关键字
- gte:大于等于
- lte:小于等于
- gt:大于
- lt:小于
- now:当前时间
POST /es_db/_search
{
  "query":{
    "range":{
      "age":{
        "gte":25,
        "lte":30
      }
    }
  }
}

POST /es_db/_search
{
  "query":{
    "range":{
      "age":{
        "gte":20,
        "lte":30
      }
    }
  },
  "from":1,
  "size":2,
  "_source":[
    "name",
    "age",
    "address"
  ],
  "sort":{
    "age":"desc"
  }
}
日期 range
DELETE /product
POST /product/_bulk
{"index":{"_id":1}}
{"price":100,"date":"2021-01-01","productId":"XHDK-1293"}
{"index":{"_id":2}}
{"price":200,"date":"2022-01-01","productId":"KDKE-5421"}


GET /product/_mapping // 查看字段属性

GET /product/_search
{
  "query":{
    "range":{
      "date":{
        "gte":"now-2y"
      }
    }
  }
}
// now-2y 为两年前
多 id 查询 ids
ids 关键字:值为数组类型,用来根据一组 id 获取多个对应的文档
GET /es_db/_search
{
  "query":{
    "ids":{
      "value":[1,2]
    }
  }
}
模糊查询 fuzzy
在实际的搜索中,我们有时候会打错字,从而导致搜索不到。在 Elasticsearch 中,我们可以使用 fuzziness 属性来进行模糊查询,从而达到搜索有错别字的情形。
fuzzy 查询会用到两个很重要的参数——fuzziness, prefix_length
- fuzziness:表示输入的关键字通过几次操作可以转变成为 ES 库里面的对应 field 的字段
- 操作是指:新增一个字符,删除一个字符,修改一个字符,每次操作可以记做编辑距离为 1
- 如中文集团中威集团编辑距离就是 1,只需要修改一个字符。
- 该参数默认值为 0,即不开启模糊查询。
- 如果 fuzziness 值在这里设置成 2,会把编辑距离为 2 的东东集团也查出来
- prefix_length:表示限制输入关键字和 ES 对应查询 field 的内容开头的第 n 个字符必须完全匹配,不允许错别字匹配
- 如这里等于 1,则表示开头的字必须匹配,不匹配则不返回
- 默认值也是 0
- 加大 prefix_length 的值可以提高效率和准确率。
GET /es_db/_search
{
  "query":{
    "fuzzy":{
      "address":{
        "value":"千弗山",
        "fuzziness":1
      }
    }
  }
}
注意
fuzzy 模糊查询 最大模糊错误 必须在 0-2 之间
- 搜索关键词长度为 2,不允许存在模糊
- 搜索关键词长度为 3-5,允许 1 次模糊
- 搜索关键词长度大于 5,允许最大 2 次模糊
高亮 highlight
highlight 关键字:可以让符合条件的文档中的关键词高亮。
highlight 相关属性:
- pre_tags 前缀标签
- post_tags 后缀标签
- tags_schema 设置为 styled 可以使用内置高亮样式
- require_field_match 多字段高亮需要设置为 false
示例数据
//指定ik分词器
PUT /products
{
  "settings" : {
    "index" : {
      "analysis.analyzer.default.type": "ik_max_word"
    }
  }
}

PUT /products/_doc/1
{
  "proId" : "2",
  "name" : "牛仔男外套",
  "desc" : "牛仔外套男装春季衣服男春装夹克修身休闲男生潮牌工装潮流头号青年春秋棒球服男 7705浅 蓝常规 XL",
  "timestamp" : 1576313264451,
  "createTime" : "2019-12-13 12:56:56"
}

PUT /products/_doc/1
{
  "proId" : "6",
  "name" : "HLA海澜之家牛仔裤男",
  "desc" : "HLA海澜之家牛仔裤男2019时尚有型舒适HKNAD3E109A 牛仔蓝(A9)175/82A(32)",
  "timestamp" : 1576314265571,
  "createTime" : "2019-12-18 15:56:56"
}
测试
GET /products/_search
{
  "query":{
    "term":{
			"name":{
        "value":"牛仔"
      }
    }
  },
  "highlight":{
    "fields":{
      "*":{}
    }
  }
}
自定义高亮 html 标签
可以在 highlight 中使用 pre_tags 和 post_tags
GET /products/_search
{
  "query":{
    "term":{
      "name":{
        "value":"牛仔"
      }
    }
  },
  "highlight":{
    "post_tags":["</span>"],
    "pre_tags":["<span style='color:red'>"],
    "fields":{
      "*":{}
    }
  }
}
多字段高亮
GET /products/_search
{
  "query":{
    "trem":{
      "name":{
        "value":"牛仔"
      }
    }
  },
  "highlight":{
    "pre_tags":["<font color='red'>"],
    "post_tags":["</font>"],
    "require_field_match":"false",
    "fields":{
      "name":{},
      "desc":{}
    }
  }
}
文档映射 Mapping
Mapping 类似数据库中的 schema 的定义,作用如下:
- 定义索引中的字段的名称
- 定义字段的数据类型,例如字符串,数字,布尔等
- 字段,倒排索引的相关配置
ES 中 Mapping 映射可以分为动态映射和静态映射。
动态映射:
在关系数据库中,需要事先创建数据库,然后该数据库下创建数据表,并创建表字段、类型、长度、主键等,最后才能基于表插如数据。而 Elasticsearch 中不需要定义 Mapping 映射,在文档写入 Elasticsearch 时,会根据文档字段自动识别类型,这种机制称之为动态映射。
静态映射
静态映射是在 Elasticsearch 中也可以事先定好映射,包含文档的各字段类型、分词器等,这种方式称之为静态眏射。
动态映射的机制,使得我们无需手动定义 Mapping, Elasticsearch 会自动根据文档信息,推算出字段的类型。但是有时候会推算不对,例如地理位置信息。当类型如果设置不对时,会导到一些功能无法正常使用,例如 Range 查询。
Dynamic Mapping 类型自动识别:
| JSON 类型 | Elasticsearch 类型 |
|---|---|
| 字符串 | 匹配日期类型,设置成 Date 配置数字设置为 float 或 long,该选项默认关闭 设置为 Text,并且增加 keyword 字段 |
| 布尔值 | boolean |
| 浮点型 | float |
| 整数型 | long |
| 对象 | Object |
| 数组 | 由第一个非空数值的类型所决定 |
| 空值 | 忽略 |
示例
// 删除原索引
DELETE /user
// 创建文档(ES根据数据类型, 会自动创建映射)
PUT /user/_doc/1
{ "name":"fox", "age":32, "address":"长沙麓谷" }
// 获取文档映射
GET /user/_mapping
思考
能否后期更改 Mapping 的字段类型?
两种情况:
- 新增加字段
- dynamic 设为 true 时,一旦有新增字段的文档写入,Mapping 也同时被更新
- dynamic 设为 false 时,Mapping 不会被更新,新增字段的数据无法被索引,但是信息会出现在_source 中
- dynamic 设置成 strict(严格控制策略),文档写入失败,抛出异常
| true | false | strict | |
|---|---|---|---|
| 文档可索引 | yes | yes | no |
| 字段可索引 | yes | no | no |
| Mapping 被更新 | yes | no | no |
- 对已有字段,一旦已经有数据写入,就不再支持修改字段定义
- Lucene 实现的倒排索引,一旦生成后,就不允许修改
- 如果希望改变类型,必须 Reindex API,重建索引
原因
- 如果修改了字段的数据类型,会导致已被索引的数据无法被搜索
- 但是如果是增加新的字段,就不会有这样的影响
测式
PUT /user
{
  "mappings":{
    "dynamic":"strict",
    "properties":{
      "name":{
        "type":"text"
      },
      "address":{
        "type":"object",
        "dynamic":"true"
      }
    }
  }
}
// 插入文档报错,原因为age为新增字段,会抛出异常
PUT /user/_doc/1
{ "name":"张三", "age":32, "address":{ "province":"山东", "city":"济南" } }
原因
dynamic 设置成 strict,新增 age 字段导致文档插入失败
修改 dynamic 后再次插入文档成功
// 修改daynamic
PUT /user/_mapping
{
  "dynamic":true
}
对已存在的 mapping 映射进行修改
具体方法:
- 如果要推倒现有的映射,你得重新建立一个静态索引
- 然后把之前索引里的数据导入到新的索引里
- 删除原创建的索引
- 为新索引起个别名
POST _reindex
{
  "source":{
    "index":user
  },
  "dest":{
    "index":"user1"
  }
}

DELETE /user

PUT /user1/_alias/user

GET /user
注意
通过这几个步骤就实现了索引的平滑过度,并且是零停机
常用 Mapping 参数配置
index:控制当前字段是否被索引,默认为 true。如果设置为 false,该字段不可被搜索
jsonDELETE /user PUT /user { "mappings":{ "properties":{ "address":{ "type":"text", "index":false }, "age":{ "type":"long" }, "name":{ "type":"text" } } } } PUT /user/_doc/1 { "name":"张三", "address":"山东济南", "age":20 } GET /user/_search { "query":{ "match":{ "address":"山东" } } }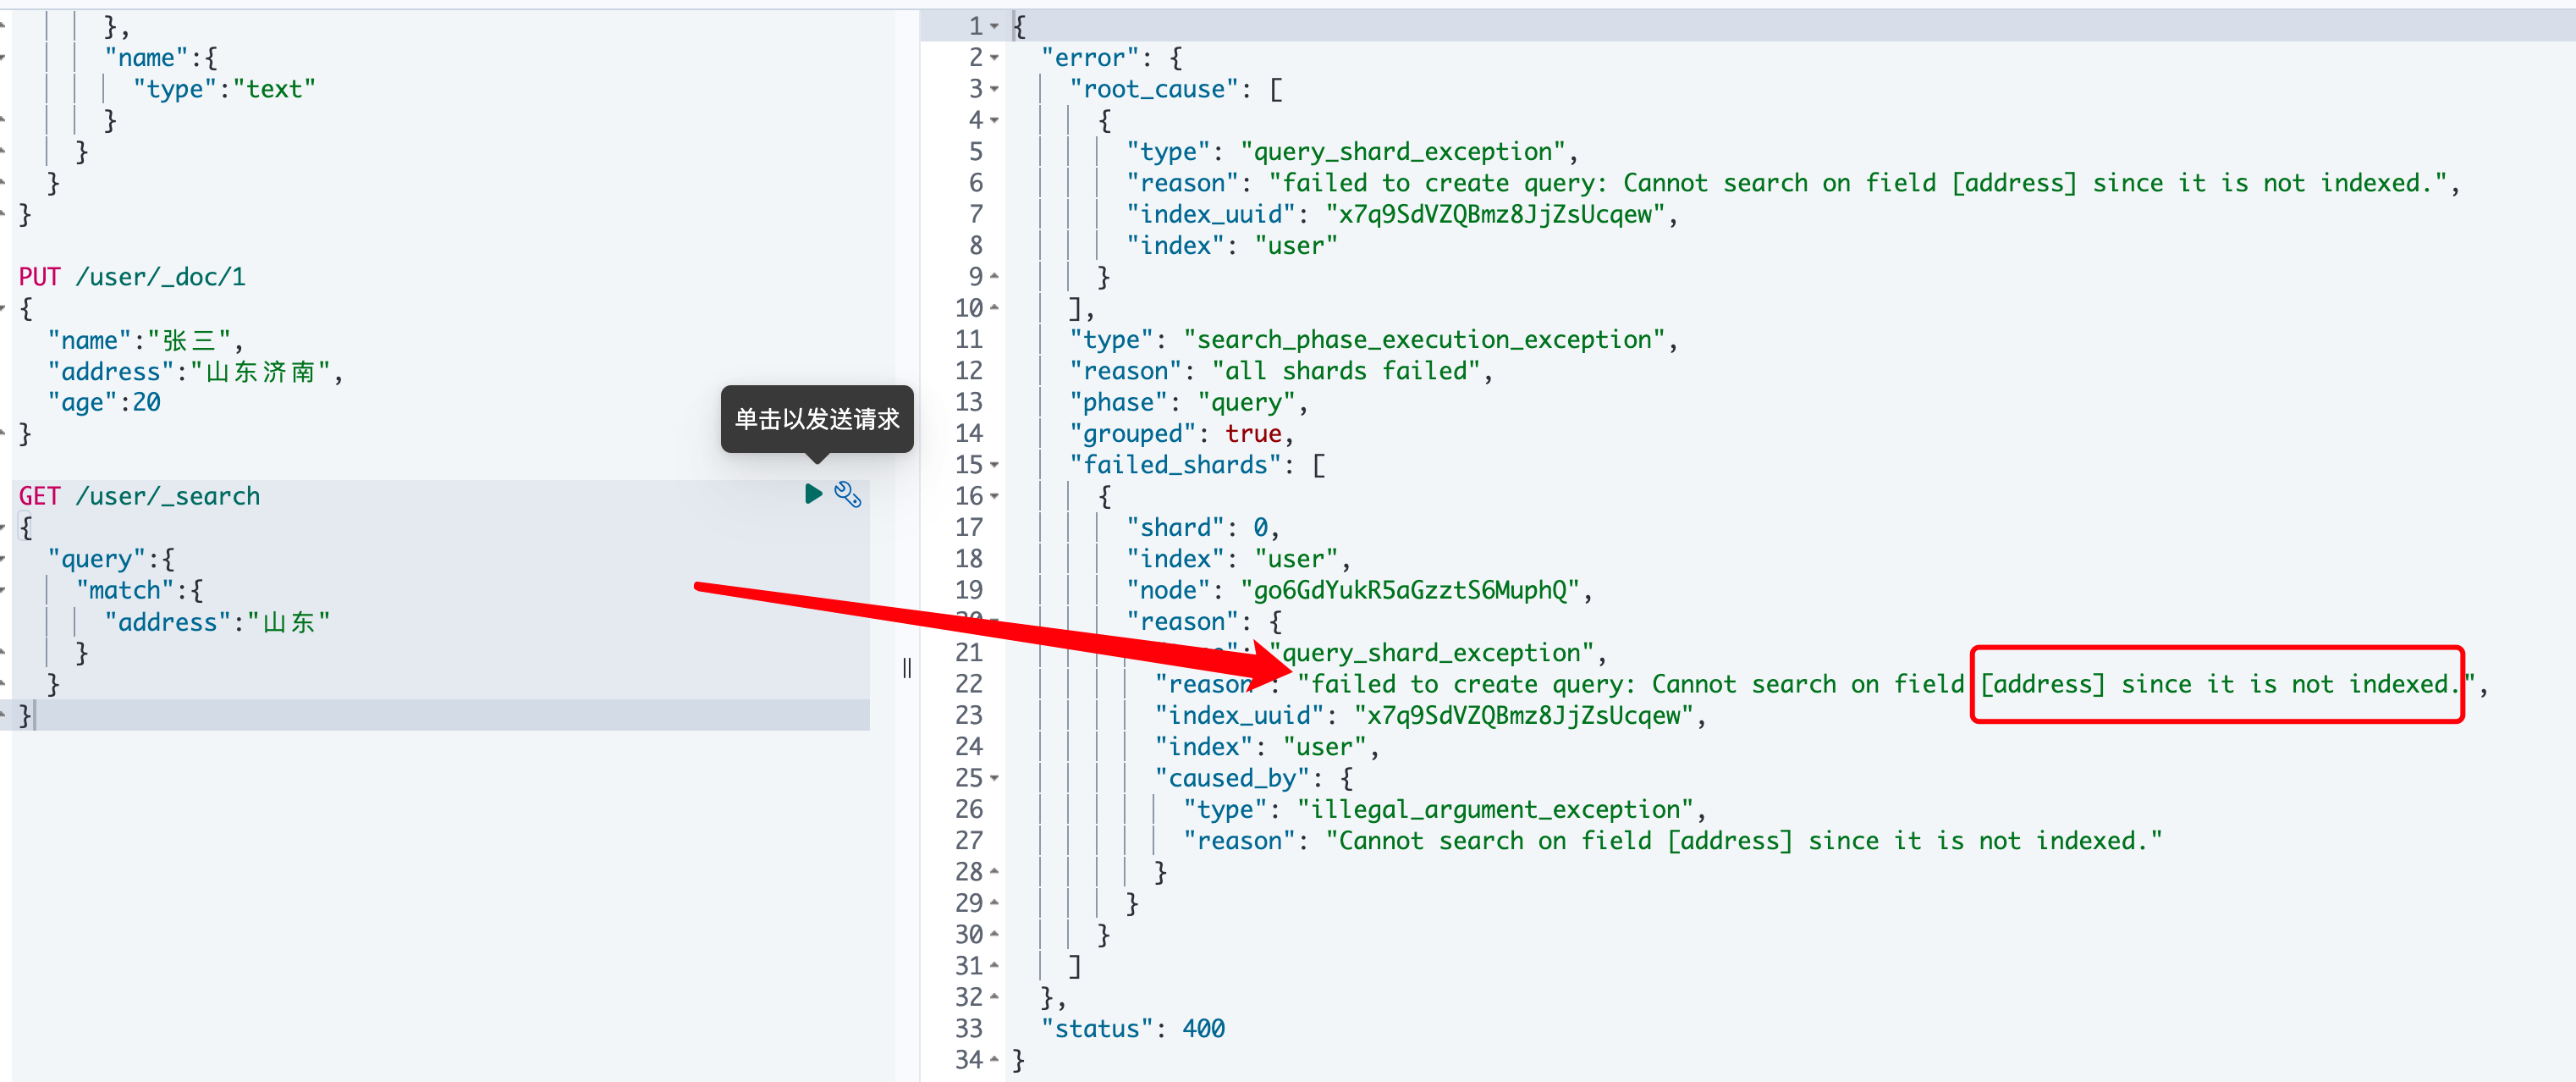
有四种不同的基本 index_options 配置,控制倒排索引记录的内容
- docs:记录 doc id
- freqs:记录 doc id 和 term frequencies(词频)
- positions:记录 doc id / term frequencies / term position
- offsets:记录 doc id / term frequencies / term position / character offects
text 类型默认记录 positions,其他默认为 docs。记录内容越多,占用存储空间越大
DELETE /user
PUT /user
{
  "mappings":{
    "properties":{
      "address":{
        "type":"text",
        "index_options":"offsets"
      },
      "age":{
        "type":"long"
      },
      "name":{
        "type":"text"
      }
    }
  }
}- null_value:需要对 Null 值进行搜索,只有 keyword 类型支持设置 null_value
DELETE /user
PUT /user
{
  "mappings":{
    "properties":{
      "address":{
        "type":"keyword",
        "null_value":"NULL"
      },
      "age":{
        "type":"long"
      },
      "name":{
        "type":"text"
      }
    }
  }
}

PUT /user/_doc/1
{
  "name":"张三",
  "address": null,
  "age":30
}

GET /user/_search
{
  "query":{
    "term":{
      "address":"NULL"
    }
  }
}- copy_to 设置:将字段的数值拷贝到目标字段,满足一些特定的搜索。copy_to 的目标字段不出现在_source 中。
// 设置copy_to
PUT /address
{
  "mappings":{
    "properties":{
      "province":{
        "type":"keyword",
        "copy_to":"full_address"
      },
      "city":{
        "type":"text",
        "copy_to":"full_address"
      }
    }
  }
}
PUT /address/_doc/1
{ "province": "山东", "city": "济南" }
PUT /address/_doc/2
{ "province": "山东", "city": "滨州" }

GET /address/_search
{ "query": { "match": { "full_address": {"query": "山东济南", "operator": "and" } } } }